معادله شرودینگر مستقل از زمان
$$\hat{H}{\Psi }^{i}={E}^{i}{\Psi }^{i}\quad {\Psi }^{i}\in {{\mathcal{H}}}^{-}\,$$
(2)
حالات الکترونیکی یک مولکول را به عنوان حالت های ویژه Ψ تعریف می کندمن از همیلتونین مولکولی \(\کلاه{H}\)، به ترتیب افزایش انرژی نمایه شده است همن. علاوه بر این، الکترونها در معرض محدودیت ضد تقارن فرمیونی هستند، یعنی محلولها باید به زیر فضای ضد متقارن فضای هیلبرت تعلق داشته باشند. \({\mathcal{H}}^{-}\). برای اینکه مسئله از نظر محاسباتی قابل حل باشد، در شیمی کوانتومی معمولاً با تقریب Born-Oppenheimer کار میکنیم، و از جفت شدن مدار اسپین و سایر اثرات نسبیتی غفلت میکنیم. برای مولکول ها، این تقریب توسط هسته به دام افتاده کولمب هامیلتونین ارائه می شود، که در اولین کوانتیزاسیون (و اعمال واحدهای اتمی) شکل می گیرد.
$${\hat{H}}=-\frac{1}{2}\mathop{\sum}\limits_{i}{\nabla }_{i}^{2}-\mathop{\sum}\limits_{iI}\frac{{Z}_{I}}{| {{\bf{R}}}_{I}-{{\bf{r}}}_{i}| }+\mathop{\sum}\limits_{i
(3)
با \({\nabla }_{i}^{2}\) نشان دهنده عملگر لاپلاس، rمن نشان دهنده موقعیت منشما الکترون و اچمن و آرمن نشان دهنده بار و موقعیت (ثابت) از منآن هسته به لطف جداسازی درجات آزادی الکترونیکی و هسته ای، معادله شرودینگر برای هر پیکربندی مولکولی به طور مستقل، با یک وابستگی پارامتریک ساده به هسته، معتبر است. این سطوح انرژی پتانسیل آدیاباتیک Born-Oppenheimer را تعریف می کند
$${\hat{H}}{\Psi }^{i}({\bf{r}}| {\bf{R}})={E}^{i}({\bf{R}}){\Psi }^{i}({\bf{r}}| {\bf{R}}).$$
(4)
بهینه سازی متغیر
برای تقریب حالت های ویژه معادله شرودینگر (2) از روش VMC استفاده می کنیم. VMC یک روش متغیر است که ضریب ریلی را به حداقل می رساند
$${{\boldsymbol{\theta }}}^{{\prime} }=\mathop{\,\mathrm{argmin}}\limits_{{\boldsymbol{\theta }}}\frac{\langle {\Psi }_{{\boldsymbol{\theta }}}| \hat{H}| {\Psi }_{{\boldsymbol{\theta }}}\rangle }{\langle {\Psi }_{{\boldsymbol{\theta }}}| {\Psi }_{{\boldsymbol{\theta }}}\rangle }$$
(5)
تابع موج نمونه پارامتری Ψθ. هدف یافتن مجموعه بهینه پارامترها است θ“، که سپس می تواند برای تخمین مقادیر مورد انتظار استفاده شود. انتگرال های با ابعاد بالا در معادله (5) با ادغام مونت کارلو با نمونه برداری از اهمیت تقریبی می شوند. این روش یکپارچهسازی تصادفی محدودیتهای بسیار کمی را روی شکل عملکردی آنساتز تابع موج قرار میدهد، که امکان گنجاندن همبستگی صریح الکترون را فراهم میکند.
در طول بهینهسازی، مقادیر مورد انتظار بر روی دستههای محدود نمونههای الکترونی استخراجشده از چگالی احتمال مرتبط با مربع تابع موج از طریق زنجیره مارکوف مونت کارلو برآورد میشوند. در هر تکرار، پارامترهای مدل با طعمی از نزول گرادیان تصادفی تا رسیدن به همگرایی به روز می شوند. جزئیات روش VMC و ویژگی های بهینه سازی تابع موج شبکه عصبی را می توان در کارهای قبلی یافت4.16.
پسوندهای مختلفی از روش VMC برای هدف قرار دادن حالت های برانگیخته وجود دارد. نیاز اصلی این گسترشها جلوگیری از فروپاشی بهینهسازی به حالت الکترونیکی زمین (حداقل انرژی جهانی) و در عین حال حصول اطمینان از همگرایی به حالتهای برانگیخته (حداقل انرژی محلی) است. در این کار، ما از روش بهینهسازی حالت برانگیخته مبتنی بر جریمه استفاده میکنیم5.21، که در آن تابع تلفات هر حالت از انرژی حالت داده شده به اضافه یک اصطلاح که همپوشانی آن را با تمام حالت های پایین تر جریمه می کند، تشکیل شده است. علاوه بر این، یک جریمه چرخش می تواند برای هدف قرار دادن حالت های خاص بخش اسپین معرفی شود6.22، منجر به از دست دادن عملکرد
$${\mathcal{L}}[{\Psi }_{{{\boldsymbol{\theta }}}_{1}},\ldots ,{\Psi }_{{{\boldsymbol{\theta }}}_{{N}_{{\rm{s}}}}}]=\mathop{\sum}\limits_{i}^{{N}_{\rm{s}}}\left[{\langle \hat{H}\rangle }^{i}+\beta {\langle {\hat{S}}^{2}\rangle }^{i}+\mathop{\sum}\limits_{j}^{j
(6)
where \({\hat{S}}^{2}\) is the total spin operator and \(\{{{\boldsymbol{\theta }}}_{1},\ldots ,{{\boldsymbol{\theta }}}_{{N}_{{\rm{s}}}}\}\) represent the parameters of the wavefunctions corresponding to each of the Ns different states. The bar (in \(\overline{\Psi }\)) indicates that no gradient is taken with respect to the parameters of the specified wavefunction. The factor β scales the spin penalty with respect to the energy and overlap contributions and is set to a fixed value (here 10). The pairwise overlap scaling parameters αij are determined via the same expression as used in our earlier work6
$${\alpha }_{ij}=\widetilde{\alpha }\, \max\left(| {E}_{{\bf{R}}}^{i}-{E}_{{\bf{R}}}^{j}| ,\,\mathrm{ewm}(\sqrt{\mathrm{Var}({E}_{{\bf{R}}}^{\mathrm{loc},i})}),1{0}^{-3}\right),$$
(7)
where \(\tilde{\alpha } > 1\) is the additional free parameter shared between all pairs of states (set to \(\widetilde{\alpha }=4\) in all experiments reported here), ewm(⋅) denotes the exponentially weighted mean over the training iterations, \({E}_{{\bf{R}}}^{\mathrm{loc},i}\) is the batch of local energies in the current step, and Var(⋅) denotes taking the variance. The first argument of the maximum function ensures that the constraint required for obtaining orthogonal states21 is fulfilled, while automatically scaling αij in a system-specific way. The second argument prevents the collapse of the states in the earliest stages of the training where our mean energy estimates cannot yet give good approximations of the energy differences.
Transferable optimization
Typically, VMC is applied in the context of single-point calculations, that is, the parameters of the trial wavefunction are optimized to minimize the energy expectation value of a specific molecular geometry. With the vastly increased expressivity of neural network wavefunctions, however, the concept of transferable optimization has been introduced. The idea consists of sharing a subset of the wavefunction parameters across multiple geometries23 or making the ansatz explicitly dependent on the nuclear geometry24, and minimizing the energy for multiple molecular geometries simultaneously. The transferable optimization makes use of the fact that under the Born–Oppenheimer approximation equation (4) the variational principle of quantum mechanics holds independently for every nuclear configuration of a molecule, that is
$${E}_{0}({\bf{R}})=\mathop{\min }\limits_{\Psi }\frac{{\langle \Psi | \hat{H}| \Psi \rangle }_{{\bf{R}}}}{{\langle \Psi | \Psi \rangle }_{{\bf{R}}}}\le \mathop{\min }\limits_{{\boldsymbol{\theta }}}\frac{{\langle {\Psi }_{{\boldsymbol{\theta }}}| \hat{H}| {\Psi }_{{\boldsymbol{\theta }}}\rangle }_{{\bf{R}}}}{{\langle {\Psi }_{{\boldsymbol{\theta }}}| {\Psi }_{{\boldsymbol{\theta }}}\rangle }_{{\bf{R}}}}\,,$$
(8)
where \({\langle \cdots \rangle }_{{\bf{R}}}\) denotes the electronic expectation value at the nuclear geometry R. In this work, we combine the optimization across multiple molecular geometries (equation (8)) with the penalty-based loss (equation (6)) and augment the wavefunction architecture to make it more suitable to the transferable set-up. This yields geometrically transferable wavefunctions capable of describing different electronic states of a molecule across a range of molecular geometries.
We generalize the training of the wavefunction model by iterating through a dataset of molecular geometries ℜ. This amounts to minimizing the average loss (equation (6)) over the whole dataset
$${{\boldsymbol{\theta }}}^{{\prime} }=\mathop{\,\mathrm{argmin}}\limits_{{\boldsymbol{\theta }}}\sum _{{\bf{R}}\in {\boldsymbol{\Re }}}{\mathscr{ \mathcal L }}[{\Psi }_{{{\boldsymbol{\theta }}}_{1}},\ldots ,{\Psi }_{{{\boldsymbol{\theta }}}_{{N}_{{\rm{s}}}}}]({\bf{R}})\,.$$
(9)
برای نمونهبرداری از الکترونها برای تخمین مقدار مورد انتظار تابع از دست دادن در هر تکرار آموزشی، از الگوریتم Metropolis استفاده میکنیم و زنجیرههای مارکوف مستقل را برای هر هندسه مجموعه دادههای درون حافظه حفظ میکنیم. برای حفظ دستههای الکترونی به اندازه کافی بزرگ (اندازههای دستهای الکترون) برای تخمینهای دقیق مقادیر مورد انتظار، مجموعه دادههای مولکولها و دستههای متوالی متناوب (اندازه دستهای مولکول) را نمونهبرداری میکنیم. اگرچه ما معتقدیم که آموزش نسبت به انتخاب دقیق اندازه دسته ای مولکول کاملاً غیر حساس است، رویکرد دایره ای با اندازه دسته مولکول یک23 می تواند باعث شود که زنجیره مارکوف سایر مولکول ها منسوخ شود، به خصوص برای مجموعه داده های بزرگ. بنابراین، هنگام در نظر گرفتن مجموعه دادههای مولکولی بزرگتر، یک مبادله بین اندازه دسته الکترون و اندازه دسته مولکول انجام میشود (جدول تکمیلی 12). برای توضیح تغییرات در توزیع الکترون به دلیل بهروزرسانی پارامترهای تابع موج، از یک نمونهبردار همبستگی استفاده میکنیم که زنجیرههای مارکوف را قبل از ترسیم هر دسته از نمونههای الکترونی متعادل میکند. در حالی که رویکرد حفظ پشتهای از زنجیرههای مارکوف مستقل برای همه مولکولهای موجود در مجموعه داده، از طریق سادگی آن، مقیاسبندی به مجموعههای داده با هزاران هندسه مولکولی، متقاعد میشود، اما در نهایت محدودیتهای خود را برطرف میکند. در این موارد، نمونهبرداری را میتوان با بهروزرسانی پیکربندیهای هستهای در زنجیرههای مارکوف و تاب برداشتن الکترونها همراه با هستهها، یا با مقداردهی اولیه زنجیرههای مارکوف جدید در هر هندسه مولکولی جدید جایگزین کرد.
نظم دهی و انتقال حالت پویا
بهینهسازی حالت برانگیخته مبتنی بر جریمه یک رویکرد نردبان حالت را اعمال میکند که در آن از فروپاشی به حالت پایه با متعامد کردن حالتهای برانگیخته با توجه به حالتهای پایینتر جلوگیری میشود (معادل (6)). ترتیب حالت حاصل در شبیهسازی تک نقطهای بیربط است، و این رویکرد بهینهسازی حالتهای خالص را تضمین میکند، برخلاف حالتهای مختلط ناشی از یک تابع تلفات متقارن که هر دو آنساتز را جریمه میکند. با این حال، هنگام گسترش تلفات به یک تنظیم قابل انتقال، ترتیب حالتها مهم میشود، زیرا ترتیب انرژی میتواند در تقاطعهای مخروطی و همسطح تغییر کند (شکل 1، سمت راست). اگرچه کاملاً ضروری نیست، اما نمایش پیوسته تابع موج در امتداد هندسه مجموعه داده هم برای بهینهسازی مدل در عمل و هم برای تفسیر آسان نتایج شبیهسازی مفید است. برای پرداختن به این موضوع، ما یک روش جریمه انعطافپذیرتر را پیشنهاد میکنیم که در آن جهت متعامدسازی بر اساس انرژیهای نسبی در هر پیکربندی تطبیق داده میشود. ما عبارت جریمه همپوشانی تابع ضرر خود را تعمیم می دهیم تا به مختصات هسته ای بستگی داشته باشد
$$\begin{array}{c}{\mathscr{ \mathcal L }}[{\Psi }_{{{\boldsymbol{\theta }}}_{1}},\ldots ,{\Psi }_{{{\boldsymbol{\theta }}}_{{N}_{{\rm{s}}}}}]({\bf{R}})=\,\ldots +\mathop{\sum}\limits_{j}^{{E}_{{\bf{R}}}^{j}
(10)
جایی که برای سادگی ما از جمع های پیکربندی صرف نظر می کنیم آر و تعداد کشورها من، همانطور که اشاره شد. توجه داشته باشید که نمایه سازی مجدد به طور مستقل برای هر پیکربندی مولکولی اعمال می شود آر ∈ ℜ. در عمل، ما مقادیر انرژی مورد انتظار معادله (10) را با حفظ میانگینهای متحرک نمایی انرژیهای آموزشی هر حالت در هر هندسه مجموعه دادهها برآورد میکنیم. با این حال، اگر ترتیب حالتهای تقریباً انحطاط در طول تمرین تغییر کند، پوسته پوسته شدن خودکار αمناو تضمین می کند که هیچ تغییر بزرگ و ناپیوسته ای در تابع ضرر ایجاد نمی شود. با گروه بندی حالت ها بر اساس ماهیت فیزیکی آنها، این به شبکه اجازه می دهد تا توابع موج را به طور موثرتری بهینه کند.
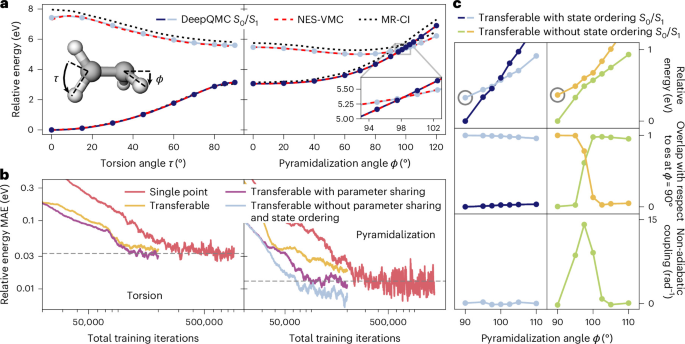
اگرچه این از دست دادن به طور دقیق ترتیب صحیح را اعمال نمی کند، اما متوجه می شویم که به دلیل صاف بودن شبکه عصبی و دینامیک بهینه سازی بهبود یافته، همانطور که در شکل 1 نشان داده شده است، پیوستگی تابع موج به طور کلی ترجیح داده می شود.
$${O}_{{{\bf{R}}}_{m}، {{\bf{R}}}_{n}}^{i،\;j}=\langle {\Psi }_{{\theta }_{i}}({\bf{r}}،{{\bf{R}}}_{m})| {\Psi }_{{\theta }_{j}}({\bf{r}}, {{\bf{R}}}_{n})\rangle \,$$
(11)
بین تابع موج قابل انتقال حالت من و او در پیکربندی هسته ای متر و ص. شکل 1c نشان می دهد که چگونه ترتیب پویا وضعیت به شبکه قابل عبور اجازه می دهد تا یک کاراکتر ثابت را در طول پیمایش حفظ کند. همپوشانی تابع موج حالت برانگیخته در ϕ = 90 درجه با خودش در هنگام تغییر ϕ نزدیک به 1 باقی می ماند، در حالی که همپوشانی آن با حالت پایه نزدیک به 0 باقی می ماند. در مقابل، بدون ترتیب پویا، شبکه کاراکتر را در محل تقاطع سوئیچ می کند و باعث می شود همپوشانی حالت برانگیخته به 0 کاهش یابد. ϕ = 100 درجه، در حالی که همپوشانی با حالت پایه به 1 افزایش می یابد. این اثر همچنین در جفت های غیردیاباتیک بین حالت پایه و حالت برانگیخته ظاهر می شود.
Ansatz یک تابع موج قابل انتقال
تمام آزمایش های گزارش شده با استفاده از ansatz مشتق شده از معماری Psiformer انجام شد11 که برای توضیح آشکار تغییرات در هندسه مولکولی گسترش یافته است. تابع موج \(\Psi :{{{{\mathbb{R}}}}}^{3N}\to {{{\mathbb{R}}}}\) با فرم معمولی Slater-Jastrow چند بدنه پارامتر می شود
$$\Psi ({\bf{r}}| {\bf{R}})=\exp (J({\bf{r}}))\mathop{\sum}\limits_{k=1}^{{N}_{\det }}\det {\ چپ[{\varphi }_{j}^{k}({{\boldsymbol{h}}}_{i}^{\mathrm{elec}}({\bf{r}}| {\bf{R}}))\,{\varphi}_{j}^{k}({{\bf{r}}}_{i}| {\bf{R}})\right]}^{{N}_{\mathrm{elec}}}_{i,\;j=1},$$
(12)
کجا \({\bf{r}}\در {{\mathbb{R}}}^{3{N}_{{\rm{elec}}}}\) مواضع هستند نبرقی الکترون ها \({\bf{r}}\در {{{{\mathbb{R}}}}}^{3{N}_{\mathrm{elec}}}\) به معنی مختصات نnuc هسته ها، جی یک عامل جاسترو تغییر ناپذیر است، \({\phi }_{j}^{k}\) اوربیتالهای «تعمیمشده» هستند که با تعبیه چند جسم پیشبینی میشوند منتو الکترون \({{\bf{h}}}_{i}^{{\rm{elec}}}\)، و \({\varphi }_{j}^{k}({{\mathbb{r}}}_{i}| {\bf{R}})\) توابع پوسته تک الکترونی هستند که به هسته متصل می شوند. عامل تعیین کننده از نبرقی × نبرقی ماتریس مداری ضد تقارن فرمیونی را تحمیل می کند و نdet چنین عواملی برای افزایش بیان آنزاک جمع می شوند. با پیروی از قرارداد استاندارد در محاسبات متغیر مونت کارلو برای سیستم های مولکولی، ما از توابع موج اختصاص داده شده با اسپین استفاده می کنیم که در آن اولین ن↑ الکترونها به چرخش بالا و بقیه اختصاص داده شده اند \({N}_{\mathrm{elec}}^{{\rm\downarrow }}={N}_{\mathrm{elec}}-{N}_{\mathrm{elec}}^{{\rm\uparrow }}\) به الکترون ها اسپین رو به پایین اختصاص داده شده است. بنابراین، پیکربندی اسپین ثابت به عنوان یک آرگومان صریح برای توابع موج ظاهر نمی شود، بلکه به طور ضمنی از طریق تخصیص اسپین گنجانده شده است.
در قلب تابع موج، معماری شبکه عصبی خودآگاه قرار دارد که پیکربندی الکترونیکی را در فضای نهفته رمزگذاری میکند. برای این منظور، بردارهای ویژگی اولیه الکترون و هسته به ترتیب از فواصل اغراق آمیز الکترون-هسته و هسته-هسته، اسپین الکترون و بارهای هسته ای ساخته می شوند.
$${{\bf{h}}}_{i}^{\mathrm{elec},0}={\mathrm{MLP}}_{\mathrm{embed}}}^{\mathrm{elec}}\left( \mathop{\oplus}\limits_{I=1}^{{N}_{\mathrm{nuc}}}(s({{\bf{r}}}_{i}-{{\bf{R}}}_{I})،\,s(| {{\bf{r}}}}_{i}-{{\bf{r}}) }_{i}،\right)$$
(13)
$${{\boldsymbol{h}}}_{I}^{{\rm{nuc}},0}={{\rm{MLP}}}_{{\rm{embed}}}}^{{\rm{nuc}}}\left(\sum _{{I}^{{\prime} }}{{\rm{MLP}}}^{{\rm{لبه}}}\left(\left(s({{\bf{R}}}_{I})\plus \,s(| {{\bf{R}}}_{I}-{{\bf{R}}}_{{I}^{{\prime\s} {Z}_{I}\راست)\راست)\راست)\,$$
(14)
که در آن ⊕ عملیات الحاق است، σمن ∈ {+1، −1} اسپین الکترون است، \({Z}_{I}\در {\mathbb{Z}}\) بارهای هسته ای هستند و MLP مخفف پرسپترون های چندلایه است. تابع س(⋅) مربوط به مقیاس لگاریتمی فاصله ها و تفاوت ها است
$$s({\bf{R}})=\frac{\mathrm{log}(1+| {\bf{R}}| )}{| {\bf{R}}| }{\bf{R}}\,$$
(15)
افزایش پایداری عددی مدل در فواصل بین ذره ای بزرگ. سپس هر لایه جاسازیها را از طریق خودتوجهی چندوجهی (علی) با اتصالات باقیمانده بهروزرسانی میکند.
$${{\bf{f}}}_{i}^{\ell +1}={{\bf{h}}}_{i}^{\ell }+{W}_{o}^{\ell },\mathop{\bigoplus}\limits_{h}\left[\frac{1}{\sqrt{d}}\mathop{\sum}\limits_{j}{\mathrm{softmax}}_{j}({({{\bf{q}}}_{i}^{\ell h})}^{T}{{\bf{k}}}_{1}^{\ell h},\ldots ,{({{\bf{q}}}_{i}^{\ell h})}^{T}{{\bf{k}}}_{{N}_{\mathrm{elec}}}^{\ell h}){{\bf{v}}}_{j}^{\ell h}\right]$$
(16)
$${{\bf{h}}}_{i}^{\ell +1}={{\bf{f}}}_{i}^{\ell +1}+\tanh \left({W}^{\ell +1}{{\bf{f}}_{i}^{\ell +1}+{b}^{\ell +1}$ راست)
(17)
با کلیدها، مقادیر و پرس و جوهای داده شده توسط
$${{\bf{q}}}_{j}^{\ell h}={W}_{q}^{\ell h}{{\bf{h}}}_{j}^{\ell },\qquad {{\bf{k}}}_{j}^{\ell h}={W}_{k}^{\{h} },\qquad {{\bf{k}}}_{j}^{\ell h}={W}_{k}^{\ell h}{{\bf{h}}}_{j}^{\ell }$$
(18)
و سافت مکساو(⋅) تابع softmax است
$${\mathrm{softmax}}_{j}({x}_{1},\ldots,{x}_{n})=\frac{\exp ({x}_{j})}{{\sum }_{i}\exp ({x}_{i})}\,.$$
(19)
ماتریس های وزن \({W}_{(\cdot )}^{\ell }\) و بردارهای انحراف بℓ نگه داشتن پارامترهای آموزش پذیر از ℓلایه ti از رمزگذار و د بعد بردارهای کلید، پرس و جو و مقدار است. در خودمراقبتی چند فصلی، چندین فصل مستقل نمایه شده توسط ساعت، ارزیابی و متصل می شوند. با الهام از تقریب Born-Oppenheimer، ما کارایی محاسبه لاپلاس درجات آزادی الکترونیکی را با محدود کردن انتقال پیام هستهای به برهمکنشهای هستهای-هستهای بهبود میبخشیم در حالی که به هستهها اجازه میدهیم حالتهای خود را به الکترونها ارائه دهند. پس از چندین لایه برهمکنش، جاسازی های چند جسمی نهایی الکترون ها برای به دست آوردن اوربیتال های تعمیم یافته پیش بینی می شود. \({\phi }_{j}^{k}={W}_{\mathrm{orb}}{{\bf{h}}}_{i}^{\mathrm{elec}}\). در همان زمان، از نمایش نهایی هسته پارامترهای توان پوسته زمناوکص با گذراندن آنها از یک واحد خطی بسته با فعال سازی سیگموئید پیش بینی می شوند.
برای حذف تنگناهای حافظه ناشی از محاسبه توابع پوسته مداری \({\varphi }_{j}^{k}\) (مراجعه 7.9) از پاکت هایی مشابه پاکت های ساده شده در ref استفاده می کنیم. 9، یعنی پاکت ها را به صورت حساب می کنیم
$${\varphi }_{j}^{k}({{\bf{r}}}_{i})=\sum _{I}^{{N}_{\mathrm{nuc}}}\sum _{n}^{3}\exp (-{\zeta }_{Ijkn}| {{\bf{r}}| {{\bf{r}}| )\,$$
(20)
کجا من مبالغ بیش از هسته و ص در مجموع سه پوسته در هر هسته را نمایه می کند.
علاوه بر این، از آنجایی که توجه به خود دسترسی مستقیم به فواصل دو الکترونی ندارد، برای گرفتن حالت آستانه الکترون-الکترون مناسب نیست. بنابراین، ما آن را با یک ضریب جاسترو دو پارامتری ساده افزایش می دهیم که شرط آستانه را به صورت تحلیلی اعمال می کند.
$$J({\bf{r}})=\mathop{\sum}\limits_{i
(21)
پارامترهای کاسپ را می توان آموزش داد و با آن مقداردهی اولیه کرد \({\alpha }_{\mathrm{par}}=\frac{1}{4}\) و \({\alpha }_{\mathrm{anti}}=\frac{1}{2}\).
به اشتراک گذاری پارامترها بین حالت های الکترونیکی
نشان داده شده است که اشتراک پارامتر در شبیه سازی قابل حمل حالت های پایه با بهره برداری از شباهت ها در توابع موج پیکربندی های مولکولی مختلف بسیار موثر است. شباهتهای مشابهی میتواند هنگام شبیهسازی چندین حالت الکترونیکی یک مولکول به وجود آید، برای مثال، به دلیل وجود اوربیتالهای زمینی که در هیچ یک از تحریکهای الکترونیکی شرکت نمیکنند. در حالی که مطالعات قبلی به ترتیب از مجموعه های مختلفی از پارامترهای مدل برای هر حالت برانگیخته استفاده می کردند5،6، پیشنهاد می کنیم بخش بزرگی از پارامترهای مدل را بین کشورها به اشتراک بگذاریم
$${\Psi }_{{{\boldsymbol{\theta }}}_{1}}({\bf{R}}),\ldots ,{\Psi }_{{{\boldsymbol{\theta }}}_{{N}_{{\rm{s}}}}}({\bf{R}}) }_{({{\boldsymbol{\theta }}}_{1}}({\bf{R}})،\ldots،{\bf{R}}) }_{({{\boldsymbol{\theta }}}_{{N}_{{\rm{s}}}}،{{\boldsymbol{\ta }}}^{{\rm{s}}})}({\bf{R}})\,.$$
(22)
اشتراک پارامتر با میانگین گیری زیر مجموعه ای از پارامترهای مدل پس از هر به روز رسانی گرادیان انجام می شود. با فرض اینکه شباهت قابل توجهی بین توابع موج حالتهای مختلف وجود دارد، اشتراک پارامتر با همبستگی نمایش فضایی نهان الکترونها در توابع موج حالتهای مختلف، لغو خطاها در انرژیهای نسبی را بهبود میبخشد و به طور موثر تعداد گامهای گرادیان دریافتی پارامترهای مشترک را افزایش میدهد. توجه به این نکته مهم است که به اشتراک گذاری پارامتر بین حالت های الکترونیکی ابزار مفیدی برای کاهش هزینه های شبیه سازی در نظر گرفته می شود. با این حال، نه به دقت بالا نیاز است و نه بهبود همگرایی تضمین شده است، به روشی شبیه به مفاهیم مرتبط مانند میانگینگیری حالت در CASSCF یا اوربیتالهای هسته منجمد در معادله حرکت جفت شده با خوشه (EOM-CC). علاوه بر این، استراتژی های بهینه به اشتراک گذاری پارامتر ممکن است به ساختار الکترونیکی سیستم مورد مطالعه بستگی داشته باشد و ممکن است در اصل در هندسه های شبیه سازی شده متفاوت باشد. از نظر تجربی، متوجه می شویم که چنین وابستگی ناچیز است. بر اساس تجربه ما، توصیه می کنیم مکانیسم مراقبت از خود را به اشتراک بگذارید. گاهی اوقات به اشتراک گذاری کسرهای بزرگی از پارامترها و در نتیجه کاهشبیان تک تک ایالت های آنزاک ممکن است از همگرایی به مجموعه صحیح حالت ها جلوگیری کند. برای در نظر گرفتن این سوگیریها، اشتراکگذاری پارامترها را میتوان در هر زمانی در طول بهینهسازی خاموش کرد، یا میتوان اثر را با کاهش کسری از پارامترهای مدل مشترک تصحیح کرد، برای مثال، فقط لایههای اولیه بلوک توجه به خود را به اشتراک گذاشت.
از آنجایی که به اشتراک گذاری پارامترها و شبه پتانسیل ها از شباهت های مرتبط بین حالت های الکترونیکی بهره می برند، مزایای اشتراک پارامتر را می توان در مقایسه شبیه سازی شبه پتانسیل با همتای تمام الکترونیکی آنها (معمولاً گران تر) کاهش داد. در همان زمان، ما هیچ تنزلی در دقت انرژیهای نسبی در هنگام ترکیب اشتراکگذاری پارامتر با شبه پتانسیل مشاهده نکردیم. تجزیه و تحلیل گسترده ای از اشتراک پارامترها در حالت های الکترونیکی برای هرمی شدن اتیلن را می توان در اطلاعات تکمیلی، بخش 4 یافت.
شبه پتانسیل ها و شبه هامیلتون ها
در حالی که الکترونهای هسته عمدتاً به انرژی کل کمک میکنند، از نظر شیمیایی بیاثر هستند و بیشتر خواص شیمیایی و پیوندی توسط الکترونهای ظرفیتی کنترل میشوند. با حذف الکترونهای هسته و نمایش اثر آنها از طریق شبه پتانسیل، تعداد الکترونهای فعال کاهش مییابد و در نتیجه همگرایی سریعتر و پایداری بهبود مییابد. این سادهسازی همچنین تابع موج ظرفیتی را هموار میکند و کارایی نمونهبرداری مونت کارلو را با اجازه دادن به اندازههای گام بزرگتر افزایش میدهد و کاهش تعداد الکترونها نیازهای حافظه را کاهش میدهد و همگرایی تابع موج را سرعت میبخشد.
یک شبه پتانسیل معمولی، مانند ccECP15 مورد استفاده برای محاسبات کاتیون متیلن آمونیوم، پتانسیل کولن هسته ای (ترم دوم در معادله (3)) را با یک عملگر غیرمحلی که بر روی مولفه های تکانه زاویه ای تابع موج عمل می کند، جایگزین می کند. 16 برای جزئیات). اگرچه این جایگزینی تا حد زیادی مشکل فیزیکی را ساده میکند، اما به دلیل انتگرالهای اضافی معرفیشده توسط عملگرهای غیرمحلی که ما با استفاده از یک طرح مربع 12 نقطهای تقریب میکنیم، سربار محاسباتی را معرفی میکند. اخیراً اشکال محلی شبه پتانسیل ها در زمینه QMC برای یادگیری عمیق معرفی شده است19و در اینجا برای مدل سازی سایت فعال روبردوکسین استفاده می شود. چنین شبه پتانسیل های محلی، که شبه هامیلتونیان نیز نامیده می شوند، انتگرال های غیر محلی گران قیمت را دور می زنند و در عین حال سطح قابل مقایسه ای از دقت را حفظ می کنند. این نشان دهنده یک بهبود قابل توجه بیشتر در کارایی محاسباتی است، بنابراین مقیاس بندی محاسبات DeepQMC را برای سیستم های با اندازه قابل توجه امکان پذیر می کند.
میزان دقت
در همه جا دقت با MAE انرژی های نسبی تعیین می شود. از آنجایی که انرژی های کل از نظر شیمیایی کمتر مرتبط هستند و به طور مستقیم بین روش ها قابل مقایسه نیستند، ما انرژی های نسبی را تخمین می زنیم، یعنی تفاوت انرژی در اشکال هندسی و حالت های الکترونیکی. برای مجموعه ای از هندسه ها {آر} و حالات من، MAE بین انرژی های DeepQMC محاسبه می شود \({E}_{{\bf{R}}}^{i}\) و انرژی های مرجع \({\tilde{E}}_{\bf{R}}^{i}\) پس از تراز کردن دو مجموعه با یک افست ثابت انتخاب شده به طوری که میانگین انرژی آنها در تمام هندسه ها و حالت های درگیر مطابقت داشته باشد.
$$\mathrm{MAE}=\frac{1}{N}\sum _{{\bf{R}},i}| {E}_{{\bf{R}}}^{i}-{\tilde{E}}_{\bf{R}}^{\;i}-\Delta | ,\qquad \Delta =\frac{1}{N}\mathop{\sum}\limits_{{\bf{R}},i}({E}_{{\bf{R}}}^{i}-{\tilde{E}}_{\bf{R}}^{\;i})،$$
(23)
کجا ن تعداد جفت های هندسه-حالت موجود در میانگین است. این آفست سراسری واحد، آفست ثابت دلخواه بین روش ها را حذف می کند و در عین حال تمام انرژی های نسبی را حفظ می کند.
اتصالات غیر آدیاباتیک
تداوم توابع موج قابل انتقال در سراسر تقاطع های سطحی را می توان با همپوشانی های بین مولکولی معادله (11) و جفت های غیر آدیاباتیک حاصل (NACs) مشخص کرد، که در شبیه سازی های جهش سطحی مرکزی هستند. NAC بین کشورها من و او با مختصات هسته ای – در شبیه سازی اتیلن (شکل 1) زاویه هرمی شدن را انتخاب کردیم. ϕ– گرادیان همپوشانی است
$${h}_{ij}(\phi )={\nabla }_{{\phi }^{{\prime} }}\langle {\Psi }_{i}(\phi )| {\Psi }_{j}({\phi }^{{\prime} })\rangle {\left\vert \right.}_{\phi = {\phi }^{{\prime} }},$$
(24)
که با اختلافات محدود تقریب می زنیم20
$${h}_{ij}(\phi )\approx \frac{1}{2{\Delta }\phi }(\langle {\Psi }_{i}(\phi )| {\Psi }_{j}(\phi +{\Delta }\phi )\rangle -\langle {\Psi }_{j}(\phi +{\Delta }\phi )\rangle ),$$
(25)
با استفاده از یک مرحله غیر یکنواخت Δϕ با فاصله مجموعه داده های هندسی تنظیم می شود. در اینجا ما جفت شدن را در امتداد مختصات هسته ای، با مشتق زمانی جفت که وارد معادلات جهش سطحی در دینامیک مولکولی می شود، و به دنبال آن انقباض با سرعت هسته ای، ارزیابی می کنیم. \(\langle {\Psi }_{i}| {\partial }_{t}{\Psi }_{j}\rangle =\langle {\Psi }_{i}| {\nabla }_{{\bf{R}}}{\Psi }_{j}\rangle \cdot {\dot{\bf){R}. با ترتیب حالت پویا، شبیهسازیهای قابل انتقال، نمایشهای شبه آدیاباتیکی را به دست میدهند، یعنی حالتهای الکترونیکی که در امتداد برش یکبعدی از طریق تقاطع مخروطی پیوسته باقی میمانند. همپوشانی آنها نزدیک به وحدت در یک ایالت و نزدیک به صفر بین ایالت ها در سراسر گذرگاه باقی می ماند، بنابراین NAC ها کوچک باقی می مانند. برعکس، در یک ترتیب ثابت، ایالت ها ماهیت عبور را معکوس می کنند و ناپیوستگی همپوشانی ها و اتصالات جعلی را ایجاد می کنند.
تنظیم محاسباتی
تمامی شبیه سازی های ارائه شده با بسته نرم افزاری DEEPQMC اجرا می شوند16.25، که اجرای JAX الگوریتم های هسته را با شتاب GPU و موازی سازی چند گره ارائه می دهد. به روز رسانی پارامترها با استفاده از الگوریتم KFAC محاسبه می شود26. برای محاسبه کارآمد عملگر انرژی جنبشی \({\sum }_{i}{\nabla }_{i}^{2}\) ما از تمایز خودکار استفاده می کنیم و از چارچوب لاپلاس رو به جلو استفاده می کنیم27. تمام آزمایشها بر روی کارتهای گرافیک NVIDIA-A100 در ابررایانه Lise در NHR@ZIB انجام شد.
خلاصه گزارش
اطلاعات اضافی در مورد طراحی مطالعه در خلاصه گزارش نمونه کارها طبیعت مرتبط با این مقاله موجود است.