مقیاس رویکرد V-SYNTHES
نسخه Enamine xREAL Space مورد استفاده در این مطالعه شامل 173 میلیارد ترکیب تولید شده از ترکیب 103879 بلوک ساختمانی منحصر به فرد و 165 واکنش شیمیایی است. این شامل 2.39 میلیارد مولکول از واکنش های 2 جزئی و 171 میلیارد مولکول از واکنش های 3 جزئی است.
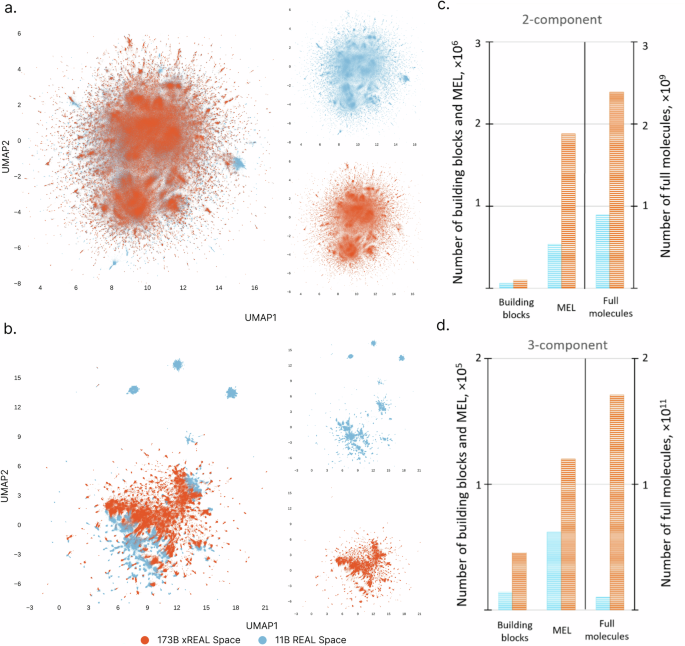
در مقایسه با نسخه 11 میلیاردی Enamine REAL Space، کل فضای شیمیایی 16 برابر افزایش یافته است. این انبساط سریع با افزایش تعداد بلوک های سازنده و تعداد واکنش های شیمیایی مناسب برای سنتز موازی به دست آمد. همانطور که انتظار می رود، بیشتر این رشد به دلیل فضای 3 جزئی است که از 10 میلیارد به بیش از 171 میلیارد مولکول افزایش یافته است (شکل 1c,d, جدول تکمیلی 1). همانطور که در جدول تکمیلی 1 نشان داده شده است، فضای واکنش 2 جزئی به درصد بسیار کمتری از کل فضای شیمیایی تبدیل شده است، از 9 درصد در نسخه 11 میلیاردی Enamine REAL Space به 1 درصد در فضای xREAL، همانطور که در جدول تکمیلی 1 نشان داده شده است. اگرچه تعداد بلوک های ساختمانی فضای 2 جزیی افزایش یافته است و اکنون 3-9 درصد از تعداد کل فضای 9 درصد افزایش یافته است. از بلوکهای سازنده، از 82 درصد، این رشد به افزایش متناسب در تنوع مولکولی تبدیل نمیشود، زیرا بیشتر گسترش فضای شیمیایی توسط واکنشهای 3 جزئی انجام میشود.
توزیعهایی برای 1 میلیون ترکیب برشماری تصادفی نمونهبرداری شده از فضاهای شیمیایی 11 میلیارد ترکیب واقعی و 173 میلیارد ترکیب xREAL که با استفاده از تقریب و طرح ریزی منیفولد یکنواخت (UMAP) مشاهده شدهاند، نشان داده شده است. الف مقایسه فضاهای واکنش دو جزئی. ترکیبات فضای واقعی به صورت دایره های آبی نشان داده می شوند. ترکیبات فضای xREAL به صورت دایره های نارنجی نشان داده شده اند. هر دو کتابخانه دارای مناطق مشابهی از فضای شیمیایی هستند. فضای xREAL خوشه بندی فشرده تری را نشان می دهد که نشان دهنده افزایش تعداد بلوک های سازنده در این زیر مجموعه است. ب مقایسه فضاهای واکنش 3 جزئی. ترکیبات فضای واقعی به صورت دایره های آبی نشان داده می شوند. ترکیبات فضای xREAL به صورت دایره های نارنجی نشان داده شده اند. فضای xREAL منطقه وسیعتری را اشغال میکند و تنوع ساختاری بهطور قابلتوجهی را نشان میدهد، مطابق با سهم غالب واکنشهای 3 جزئی در گسترش کلی xREAL. ج مقایسه اندازه زیرفضاهای 2 جزئی فضاهای شیمیایی REAL با 11 میلیارد ترکیب و xREAL با 173 میلیارد ترکیب، که تعداد ترکیبات برشماری شده، بلوک های ساختمانی منحصر به فرد و قطعات MEL را در هر کتابخانه نشان می دهد. د مقایسه اندازه زیرفضاهای 3 جزئی فضاهای شیمیایی REAL با 11 میلیارد ترکیب و xREAL با 173 میلیارد ترکیب، که تعداد ترکیبات شمارش شده، بلوک های ساختمانی منحصر به فرد و قطعات MEL را در هر کتابخانه نشان می دهد. تقریب و پیشبینی منیفولد یکنواخت UMAP، فضای واقعی، فضای دسترسی آسان، فضای xREAL، فضای قابل دسترسی گسترده، کتابخانه شمارش حداقل MEL.
در فضای xREAL، مولکول های دو جزئی تا حد زیادی خواصی مشابه با نسخه 11 میلیاردی Enamine REAL Space حفظ کردند (شکل تکمیلی 1). در همان زمان، فضای xREAL 3 جزئی به مولکولهای بزرگتر با وزن مولکولی متوسط ~ 550 اینچ دالتون و 90 درصد مولکولها در محدوده 420 تا 690 اینچ گسترش یافت. رویکرد V-SYNTHES2 دری را برای غربال کردن مولکولهای بزرگتر در این فضای xREAL، در صورت نیاز، هنگام هدف قرار دادن جیبهای اتصال بازتر و بزرگتر که یک چالش بزرگ در کشف دارو محسوب میشود، باز میکند. برای مقایسه تنوع شیمیایی Enamine REAL Space (11 میلیارد ترکیب، 2019) با Enamine xREAL Space توسعه یافته (173 میلیارد ترکیب، 2022)، توزیع ترکیبات در فضای شیمیایی را با استفاده از تقریب و طرح ریزی منیفولد یکنواخت (UMAP) مشاهده کردیم. شکل 1 1 میلیون ترکیب تصادفی شمارش شده از 2 جزء را نشان می دهد (پانل الف) و 3 جزئی (پانل ب) فضاهای واکنش.
در فضای دو جزئی، ترکیبات از هر دو کتابخانه REAL و xREAL مناطق مشابهی از فضای شیمیایی را پر می کنند. با این حال، فضای xREAL خوشه بندی فشرده تری را نشان می دهد که نشان دهنده افزایش اندازه این زیر مجموعه است.
در مقابل، فضای واکنش 3 جزئی تفاوت قابل توجهی را نشان می دهد. ترکیبات xREAL دامنه وسیع تری را در بر می گیرند و تنوع ساختاری قابل توجهی را در مقایسه با ترکیبات REAL نشان می دهند. از آنجایی که واکنشهای 3 جزء بخش بزرگی از فضای xREAL را تشکیل میدهند، این پسوند تنوع شیمیایی آن را تا حد زیادی بهبود میبخشد و xREAL را برای تشخیص ضربه در غربالگری مجازی در مقیاس گیگا ارزشمند میکند.
همانطور که در جدول 1 نشان داده شده است، هزینه محاسباتی مورد نیاز برای نمایش مجازی 173 میلیارد فضای کامل با استفاده از الگوریتم V-SYNTHES2 در مقایسه با غربالگری 11 میلیارد فضای واقعی تنها 10 تا 15 درصد افزایش یافته است. افزایش هزینه ناشی از افزایش تعداد بلوک های ساختمانی است که به یک MEL بزرگتر تبدیل می شود. در این مطالعه، ما همان تعداد مولکولهای کاملاً شمارش شده را برای اتصال نهایی (1 میلیون ترکیب) انتخاب کردیم. اگرچه اندازه MEL از 659000 ترکیب به 2 میلیون مولکول افزایش یافته است، کل هزینه محاسباتی مورد نیاز برای غربالگری 2 میلیون MEL در مقایسه با کتابخانه کاملاً شمارش شده کم است، زیرا کاندیدهای MEL مولکولهای قطعهمانند کوچکی با تعداد کمی از پیوندهای قابل چرخش با استفاده از پیوندهای استاندارد به 8 هستند. تنظیمات V-SYNTHES2 (تلاش برای اتصال 2).
انتخاب مدل ساختاری SARS-CoV-2 NSP13
به عنوان بخشی از چالش شماره 2 CACHE، از رویکرد V-SYNTHES2 برای غربالگری 173 میلیارد ترکیب فضایی xREAL در برابر SARS-CoV-2 هلیکا NSP13 استفاده شد. NSP13 یک هلیکاز از خانواده 1B است که از هیدرولیز تری فسفات نوکلئوتیدی برای برش 5’→3′ DNA یا RNA دو رشته ای استفاده می کند. NSP13 به دلیل نقش حیاتی آن در تکثیر SARS-CoV به عنوان هدف در این چالش انتخاب شد. نکته قابل توجه، محفظه اتصال به RNA NSP13 یکی از مناطق بسیار حفاظت شده در کروناویروس ها است که آن را به یک هدف ضد ویروسی جذاب و بالقوه گسترده تبدیل می کند.37,38.
چهار ساختار به عنوان بخشی از غربالگری کریستالوگرافی برای قطعاتی که NSP13 را هدف قرار میدهند حل شدند (PDB ID: 5RLH، 5RLZ، 5RML، 5RMM)38 توسط برگزار کننده چالش CACHE برای یک نمایش مجازی ارائه شد. در حالی که 5RLH، 5RLZ، و 5RMM همه شامل قطعات محدود شده در پاکت اتصال RNA بودند، 5RML حاوی یک قطعه بود که به خوبی خارج از این منطقه قرار داشت و بنابراین از تجزیه و تحلیل بیشتر حذف شد. تمام قطعات متبلور شده در 5RLH (K2D)، 5RLZ (VWM) و 5RMM (VXG) حاوی گروه های کربوکسیلیک اسید هستند. قابل ذکر است، در 5RLZ (VWM) و 5RMM (VXG)، گروههای کربوکسیل همان محل اتصال را اشغال میکنند و یک پیوند هیدروژنی حفاظتشده با N516 تشکیل میدهند، که اهمیت این باقیمانده را در تشخیص لیگاند برجسته میکند. در مقابل، اگرچه 5RLH (K2D) همچنین حاوی یک اسید کربوکسیلیک است، اما جهت گیری فضایی متفاوتی را اتخاذ می کند و پیوندهای هیدروژنی را با Y515 و T552 تشکیل می دهد. بر اساس این وضعیت اتصال و تعامل حفظ شده، 5RLZ و 5RMM برای تجزیه و تحلیل بیشتر انتخاب شدند.
به دلیل عدم وجود ترکیبات فعال شناخته شده، امکان اعتبارسنجی دقیق مدل یا بهینه سازی هدایت لیگاند وجود نداشت.39. بنابراین، تکرارپذیری برای دو قطعه متبلور شده (PDB IDs 5RMM و 5RLZ) که موقعیت اتصال کربوکسیلیک اسید یکسانی دارند به عنوان معیار اصلی برای ارزیابی مدلهای داکینگ مورد استفاده قرار گرفت. هر دو مدل تطابق خوبی بین پوزهای پین شده و آزمایشی نشان دادند. با این حال، مدل مبتنی بر ساختار 5RLZ به مقادیر RMSD کمتری دست یافت (تقریباً 2.0 و 1.6 Å؛ شکل 2) و نتایج Docking مطلوب تری ارائه داد. علاوه بر این، گروه کربوکسیلیک اسید قطعه آویز یک پیوند هیدروژنی حفظ شده با باقیمانده N516، مطابق با ساختار کریستالی، حفظ می کند. بر اساس این سطح بالایی از دقت وضعیت، مدل مشتق شده از 5RLZ برای غربالگری مجازی بعدی انتخاب شد.
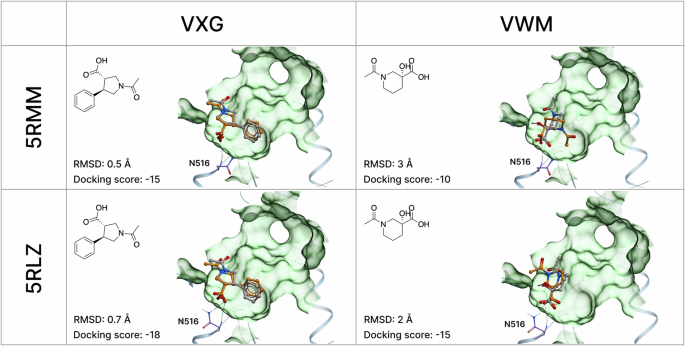
موقعیتهای اتصال کریستالوگرافی تجربی قطعات متبلور شده با موقعیتهای اتصال محاسباتی در پاکت اتصال RNA هلیکاز SARS-CoV-2 NSP13 مقایسه میشود. حالت های آزمایشی برای قطعات VXG (PDB ID: 5RMM) و VWM (PDB ID: 5RLZ) به صورت چوب خاکستری نشان داده شده است. ژست های سنجاق شده به صورت چوب های نارنجی نشان داده می شوند. مدل مبتنی بر ساختار 5RLZ مقادیر انحراف میانگین مربعات ریشه (RMSD) تقریباً 2.0 Å و 0.7 Å را برای دو قطعه به دست آورد و برای غربالگری مجازی بعدی بر اساس دقت موقعیت برتر و نتایج اتصال مطلوب تر انتخاب شد. پیوند هیدروژنی حفظ شده بین گروه اسید کربوکسیلیک قطعه آویز و باقیمانده N516 با خطوط چین دار سیاه نشان داده می شود. پروتئین غیرساختاری NSP13 13، سندرم حاد تنفسی SARS-CoV-2 کروناویروس 2، بانک اطلاعات پروتئین PDB، انحراف ریشه میانگین مربعات RMSD، اسید ریبونوکلئیک RNA.
غربالگری V-SYNTHES2 برای عوامل اتصال کاندید به SARS-CoV-2 NSP13
غربالگری ترکیب با V-SYNTHES2 شامل چندین مرحله کلیدی است: اتصال MEL، شمارش تکراری و اتصال مولکولهای کامل، پس پردازش نیمه خودکار شامل فیلتر کردن شباهت و تازگی دارو، امتیازدهی مجدد برترین موفقیتها و خوشهبندی مبتنی بر synthon، که هر کدام با استفاده از اسکریپتهای اختصاصی و بررسی نهایی داخلی انجام شده است. شکل 3).
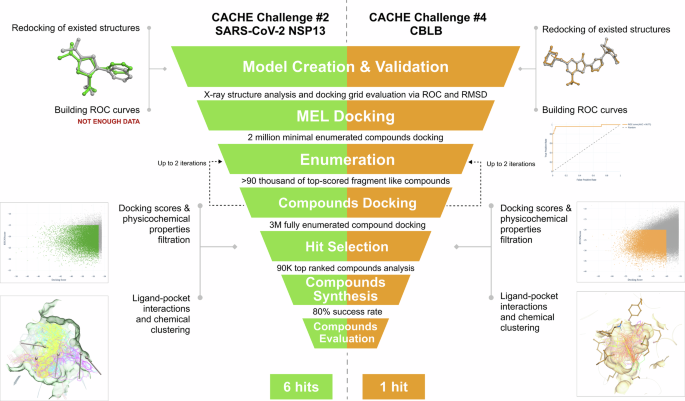
شکل، مراحل متوالی خط لوله غربالگری مجازی مبتنی بر ساختار V-SYNTHES2 را همانطور که در این مطالعه پیاده سازی شده است، نشان می دهد. مرحله 1: تولید یک کتابخانه شمارش حداقلی (MEL) از ترکیبات قطعه مانند که همه ترکیبات منحصر به فرد synthon- داربست را در فضای Enamine xREAL نشان می دهد. مرحله 2a: اتصال قطعات MEL به جیب اتصال گیرنده آماده شده با استفاده از ICM-Pro v3.9. مرحله 2b: فیلتر کردن قطعات MEL متصل شده بر اساس امتیاز اتصال و آستانه امتیاز RTCNN. مرحله 3: شمارش تکراری قطعات MEL انتخاب شده در تقریباً 1-2 میلیون ترکیب کاملاً شمارش شده در هر زیر مجموعه واکنش با جایگزینی گروه های R محدود شده با synthon های واقعی از فضای xREAL. مرحله 4: اتصال نهایی ترکیبات کاملاً شمارش شده و به دنبال آن پس پردازش خودکار شامل فیلتر PAINS، فیلتر قانون Lipinski، فیلترهای سمیت و واکنش پذیری، خوشه بندی مبتنی بر synthon و بازرسی بصری متخصص برای انتخاب تقریباً 100 ترکیب برای سنتز و آزمایش تجربی.
همانطور که قبلا توضیح داده شد14.32 کتابخانه های واکنش 2 جزئی و 3 جزئی به طور جداگانه غربالگری شدند. 1.88 میلیون قطعه MEL برای واکنش های 2 جزئی و 120 هزار MEL برای واکنش های 3 جزئی به مدل ساختاری NSP13 متصل شدند. پس از شمارش تکراری و اتصال مولکولهای کامل، 90000 ترکیب با امتیاز بالا برای پردازش بیشتر، 30000 برای واکنشهای 2 جزیی و 60000 برای واکنشهای 3 جزیی انتخاب شدند.
ترکیبات در ابتدا بر اساس امتیاز اتصال (قطع: -35.0) همراه با امتیاز شبکه عصبی کانولوشنال شعاعی و توپولوژیکی (RTCNN) فیلتر شدند.40 (محدود: -15.0) همانطور که در ICM-Pro (Molsoft) پیاده سازی شده است. مجموعه از پیش فیلتر شده با حذف PAINS، گروههای عملکردی ناخواسته و ترکیبات ناقض قانون پنج لیپینسکی (Ro5) که توسط دستورالعملهای چالش CACHE لازم است، بیشتر اصلاح شد. تأثیر هر مرحله فیلتر بر تعداد ترکیبات باقیمانده در جدول تکمیلی 2 خلاصه شده است. کاربرد ترکیبی امتیاز اتصال، RTCNN، فیلترهای فیزیکوشیمیایی و سمیت/واکنشپذیری 90000 ترکیب اولیه با امتیاز بالا را به حدود 3000 کاندید قبل از خوشهبندی و بازرسی بصری متخصص کاهش داد.
سپس زیرمجموعه حاصل با استفاده از تنظیمات عمق افزایش یافته (تنظیم شده روی 5) مجدداً متصل شد تا پوزهای صحافی و امتیازات صحافی دقیق تری ایجاد شود. متعاقباً فعل و انفعالات لیگاند-پروتئین برای شناسایی فرضیههای اتصال مختلف برای چگونگی اشغال کردن پاکت هدف مورد تجزیه و تحلیل قرار گرفت (شکل تکمیلی 2). چهار فرضیه الزام آور در استراتژی انتخاب در نظر گرفته شد. فرضیه اول نشان میدهد که ترکیبات میتوانند برهمکنشهای RNA را در جیب اتصال RNA NSP13 تقلید کنند. دومی بر روی ترکیباتی متمرکز شد که میتوانند ورودی کانال اتصال RNA را مسدود کنند و در نتیجه دسترسی به RNA را مسدود کنند. فرضیه سوم ترکیباتی را هدف قرار می دهد که قادر به درگیر کردن باقی مانده های کلیدی در نزدیکی سطح اتصال RNA هستند، به ویژه N516 و S486، که بر اساس برهمکنش های پیوند هیدروژنی حفظ شده آنها انتخاب شدند. ارتباط با گروه های عاملی کربوکسیلیک اسید قطعات متبلور شده. در نهایت، فرضیه چهارم شامل یک انتخاب بیطرفانه از ترکیبات با بهترین امتیاز است که صرفاً با نتایج docking اولویتبندی میشود، بدون محدودیت در حالت اتصال.
برای افزایش تنوع انتخاب نهایی، ترکیبات در هر فرضیه با استفاده از یک الگوریتم مبتنی بر synthon سفارشی که از ماهیت ترکیبی فضای Enamine xREAL استفاده میکند و خوشهبندی بهبود یافته را در مقایسه با خوشهبندی سنتی مبتنی بر اثر انگشت ارائه میکند، خوشهبندی شدند.
در نهایت، موقعیت اتصال 1000 ترکیب توسط کارشناسان شیمیدان دارویی بررسی شد و فهرست نهایی ترکیبات (100 ترکیب) برای سنتز و آزمایش آزمایشگاهی در برابر NSP13 انتخاب شد.
سنتز برای 77 ترکیب (به معنی موفقیت سنتز 77 درصد) برای ارزیابی تجربی (جدول تکمیلی 3) موفقیت آمیز بود. به طور کلی، 11 روش مصنوعی مختلف (به روشها مراجعه کنید) برای جمعآوری مولکولهای انتخابی استفاده شد. تمام ترکیبات انتخاب شده توسط Enamine با خلوص بیش از 95٪ (به جز 3 ترکیب با خلوص بیش از 90٪) سنتز شدند. اطلاعات توصیفی تحلیلی برای همه ترکیبات سنتز شده در اطلاعات تکمیلی ارائه شده است.
خصوصیات لیگاندهای جدید SARS-CoV-2 NSP13
غربالگری اولیه 77 ترکیب سنتز شده با استفاده از رزونانس پلاسمون سطحی (SPR) و روش مهار ATPase در غلظت 50 میکرومولار انجام شد. پروتکلهای دقیق برای توصیف بیولوژیکی مولکولهای سنتز شده قبلاً توسط سازماندهندگان CACHE منتشر شده بود.41به طور کلی، بر اساس اتصال نسبی در روش SPR و مهار در روش ATPase، 37 (48٪) و 13 (17٪) ترکیبات، به ترتیب به آزمایش دوز-پاسخ پیشرفت کردند. 6 ترکیب (8٪) در روش SPR نشان داده شد کد مقادیر 43 میکرومولار یا کمتر، با بهترین ترکیب که میل ترکیبی 7 میکرومولار را برای NSP13 نشان میدهد. در روش ATPase، 6 ترکیب دیگر (8٪) IC50 را نشان دادند50 کمتر از 50μM همانطور که در سند نتایج CACHE #2 توضیح داده شده است17یک همبستگی بسیار ضعیف بین ترکیبات موفق شناسایی شده توسط SPR و آنهایی که در روش ATPase در تمام انتخاب های موفق بالقوه یافت می شوند مشاهده شد. بنابراین، سازماندهندگان CACHE تصمیم گرفتند روی دادههای میل پیوند اتصال SPR تمرکز کنند و دادههای ATPase را از تجزیه و تحلیل بعدی برای همه گروههای شرکتکننده حذف کنند.
هر شش ضربه در شکل 4 هیچ اتصال قابل توجهی به پروتئین WDR9 نامرتبط، و همچنین مشکلات تجمع یا حلالیت را نشان ندادند و به عنوان بازدیدهای تایید شده تعیین شدند. همچنین لازم به ذکر است که مقایسه با لیگاندهای SARS-CoV-2 هلیکاز NSP13 فهرست شده در ChEMBL تأیید کرد که هیچ آنالوگ نزدیکی در بین بازدیدهای تأیید شده وجود ندارد (شباهت با Tanimoto 3). برای اثبات بیشتر این تازگی، مقایسه ای با پایگاه داده کامل ChEMBL انجام شد. برای پنج مورد از شش ضربه تایید شده، هیچ آنالوگ با شباهت Tanimoto > 0.6 در ChEMBL در برابر هیچ هدف بیولوژیکی یافت نشد. برای ترکیب CACHE2_1418_3، دو آنالوگ (Tanimoto > 0.6) با فعالیت گزارش شده علیه پروتئین های نامرتبط، تیروسیل-DNA فسفودی استراز و هیستون-لیزین N-متیل ترانسفراز شناسایی شد، در حالی که هیچ آنالوگ نزدیکی علیه NSP13 یا اهداف مرتبط با ویروس کرونا یافت نشد.
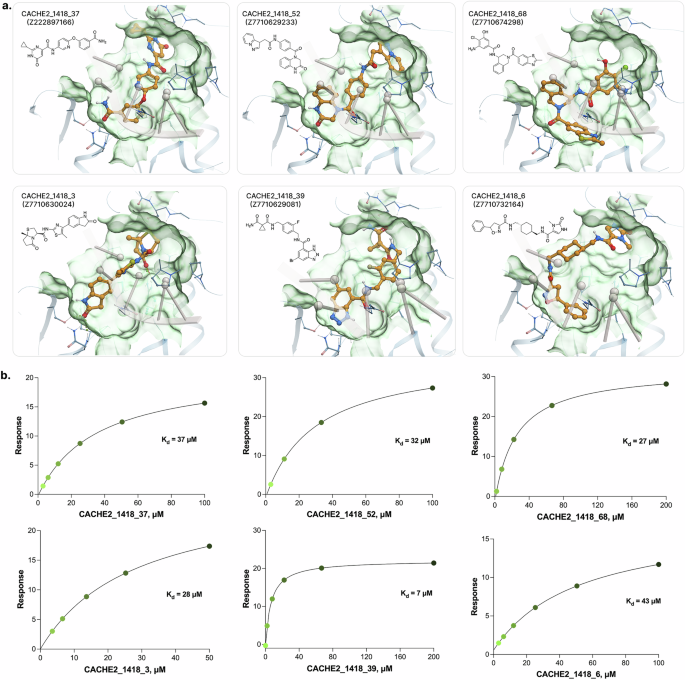
الف ساختارهای شیمیایی و موقعیت های اتصال پیش بینی شده شش ترکیب موفق تایید شده در شیار اتصال RNA هلیکاز SARS-CoV-2 NSP13. سطح پروتئین به رنگ سبز نشان داده شده است. ترکیبات ضربه ای به صورت چوب های رنگی نشان داده می شوند. فعل و انفعالات پیوند هیدروژنی با باقیمانده های محل اتصال کلید با خطوط چین سیاه نشان داده می شود. ب منحنیهای دوز-پاسخ رزونانس پلاسمون سطحی (SPR) برای شش ترکیب موفق تایید شده. هر منحنی واکنش اتصال را به عنوان تابعی از غلظت ترکیب نشان می دهد و ثابت های تفکیک (کد) از 7 میکرومولار تا 43 میکرومولار متغیر است. شناسههای ترکیبی از قرارداد نامگذاری CACHE2_1418_XX پیروی میکنند که توسط سازماندهندگان چالش CACHE تعریف شده است. پروتئین غیر ساختاری NSP13 13، SARS-CoV-2 سندرم حاد تنفسی شدید کروناویروس 2، رزونانس پلاسمون سطحی SPR، کد ثابت تفکیک تعادل، اسید ریبونوکلئیک RNA، CACHE ارزیابی بحرانی آزمایشهای ضربهیابی محاسباتی.
این مربوط به نرخ ضربه 8 درصدی برای رویکرد V-SYNTHES2 است، که آن را در بین سه جریان کاری برتر در مرحله شناسایی بازدید چالش شماره 2 CACHE قرار می دهد. اکثر 23 گردش کار باقیمانده نرخ ضربه بین 0٪ تا 3٪ را با میانگین کلی 2.3٪ تولید کردند. علاوه بر این، رویکرد V-SYNTHES2 در میان 10 روش برتر بر اساس امتیاز خلاصه بازدیدهای غربالگری مجازی که توسط کمیته CACHE تعیین شده بود، قرار گرفت.17.
خواص فیزیکوشیمیایی و کارایی لیگاند شش ضربه تایید شده در جدول تکمیلی 3 خلاصه شده است. ضربه های تایید شده محدوده وزن مولکولی 391-493 اینچ دالتون را با مقادیر logP محاسبه شده بین 1.1 و 4.0، مطابق با یک فضای شیمیایی شبیه به دارو را در بر می گیرد. مقادیر کارایی لیگاند (LE) از 0.17 تا 0.24 اینچ کیلوکالری در مول در هر اتم سنگین است که منعکس کننده ماهیت چالش برانگیز محل اتصال به RNA NSP13 است. هر شش ضربه، گزینش پذیری را نسبت به پروتئین WDR9 نامرتبط نشان دادند، بدون اینکه اتصال قابل توجهی مشاهده شود، و تعامل خاص هدف را تأیید کرد.
تجزیه و تحلیل حالتهای اتصال پیشبینیشده بازدیدهای تایید شده در رابطه با فرضیههای اتصال اولیه (شکل 5a) نشان داد که چهار ترکیب احتمالاً با مسدود کردن ورودی کانال اتصال RNA عمل میکنند – CACHE2_1418_37، CACHE2_1418_52، CACHE2_1418_3_3، در حالی که دو ترکیب دیگر تا CACHE2_1418_2_9_3، CACHE2_1418_3_3، به نظر میرسند: برهمکنش های RNA در پاکت اتصال – CACHE2_1418_6، CACHE2_1418_68.
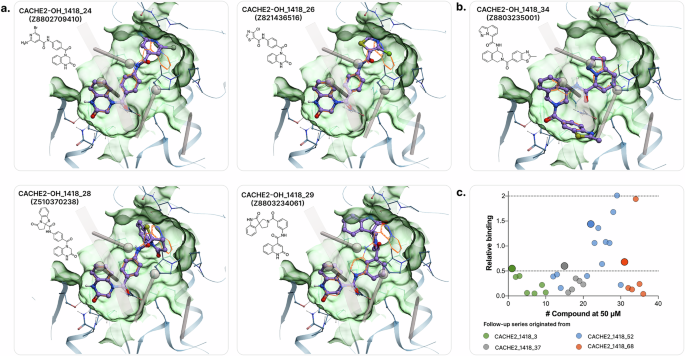
آنالوگ های فعال از دو سری موفقیت والدین و داده های اتصال SPR برای همه 32 ترکیب دور 2 نشان داده شده است. الف ساختارهای شیمیایی و موقعیتهای اتصال پیشبینیشده آنالوگهای گرد ۲ فعال تولید شده از ترکیب اصلی CACHE2_1418_52 نشاندادهشده در پاکت اتصال RNA NSP13. ب ساختار شیمیایی و موقعیت اتصال پیشبینیشده آنالوگ حلقه فعال ۲ تولید شده از ترکیب اصلی CACHE2_1418_68. ج داده های اتصال رزونانس پلاسمون سطحی (SPR) برای هر 32 دور از 2 ترکیب سنتز شده و 4 ترکیب اولیه. هر سری با رنگ متفاوتی به تصویر کشیده شده است: سری CACHE2_1418_3 در دایره های سبز، سری CACHE2_1418_37 در دایره های خاکستری، سری CACHE2_1418_52 در دایره های آبی، و سری CACHE2_1418_68 در دایره های قرمز. در هر سری، ترکیب اصلی با یک فرم بزرگتر و با رنگ شدیدتر نشان داده می شود. آنالوگ ها با فرم های کوچکتر با رنگ روشن تر نشان داده می شوند. اگرچه تعداد محدود آنالوگ ها برای ایجاد یک مدل QSAR پیش بینی کافی نبود، تجزیه و تحلیل ساختاری ترکیبات فعال روندهای SAR قابل تفسیر را نشان داد که نقاط لنگر برای بهینه سازی سرب آینده را شناسایی می کند. رزونانس پلاسمون سطحی SPR، کد ثابت تفکیک تعادل، رابطه ساختار-فعالیت SAR، رابطه ساختار-فعالیت کمی QSAR، پروتئین غیر ساختاری NSP13 13، فضای xREAL گسترشیافته REAdily Accessible Space، اهداکننده پیوند هیدروژنی HBD، CACHE ارزیابی انتقادی آزمایشهای ضربهیابی محاسباتی.
گسترش محدود تعداد بازدیدهای اولیه V-SYNTHES2 برای SARS-CoV-2 NSP13
برای تولید 4 سری بعدی (CACHE2_1418_3، CACHE2_1418_37، CACHE2_1418_52 و CACHE2_1418_68) برای چهار بازدید تایید شده اولویتبندی شده برای مطالعه بیشتر، از چندین رویکرد مکمل با استفاده از Enamine xREAL Space استفاده کردیم. ابتدا، آنالوگ های نزدیک با استفاده از روش های جستجوی فضای قطعه شامل FTrees، SpaceMACS و SpaceLight شناسایی شدند.42،43،44. دوم، ما از مدولار بودن synthon فضای xREAL با اتصال مکرر یک synthon (برای واکنشهای 2 جزئی) یا دو synthon (برای واکنشهای 3 جزء) در حالی که سایر synthonها را تغییر میدهیم، استفاده کردیم، که امکان بررسی سیستماتیک روابط ساختار-فعالیت (SAR) را فراهم میکند. آنالوگهای تولید شده با استفاده از تنظیماتی که در بالا در «آمادهسازی مدل و غربالگری برای SARS-CoV-2 NSP13» توضیح داده شد، متصل شدند.
از 75 آنالوگ پیشرفته برای سنتز، 32 (43٪) با موفقیت در 4 اجرای بعدی سنتز شدند (جدول تکمیلی 4). میزان موفقیت نسبتاً پایین سنتز عمدتاً به دلیل در دسترس بودن محدود یکی از بلوکهای سازنده است که از تکمیل تمام آنالوگهای مورد نظر جلوگیری میکند. برنامه فشرده پروژه مانع از تلاش برای سنتز مجدد می شود. اطلاعات توصیفی تحلیلی برای همه ترکیبات سنتز شده در اطلاعات تکمیلی ارائه شده است.
برای ارزیابی تازگی آنالوگ های سنتز شده، شباهت Tanimoto در برابر تمام ترکیبات ChEMBL با فعالیت گزارش شده علیه اهداف SARS-CoV-2 محاسبه شد. هیچکدام از آنالوگها از شباهت تانیموتو 0.6 فراتر نرفتند، که تأیید میکند که ترکیبات سنتز شده در مقایسه با لیگاندهای شناخته شده SARS-CoV-2، ماده شیمیایی جدیدی را نشان میدهند (جدول تکمیلی 5).
32 آنالوگ سنتز شده در جریان کاری مشابه راند 1 مورد آزمایش مجدد قرار گرفتند، که قبلاً پروتکل های مفصلی برای آن منتشر شده بود.17. در سری های CACHE2_1418_3 (سبز) و CACHE2_1418_37 (خاکستری)، مولکول های بعدی هیچ فعالیت اتصالی نشان ندادند (شکل 5). در مقابل، 4 مورد از سری CACHE2_1418_52 (آبی) و 1 ترکیب از سری CACHE2_1418_68 (قرمز) فعالیت اتصالی را از 48 میکرومولار تا 189 میکرومولار نشان دادند (جدول تکمیلی 4).
در سری CACHE2_1418_3، ده آنالوگ برای جایگزینی گروه آسیل اصلی با جایگزینهای ساختاری متنوع، از جمله لاکتامهای دو حلقهای، تریمتوکسی فنیل، مشتقات ساخارین، ایندازولها و هتروسیکلهای کلر ساخته شد. هیچ یک از ده آنالوگ فعالیت اتصالی را نشان ندادند، که نشان میدهد جایگزینهای گروه آسیل آزمایششده تحمل نشدند. الزامات ساختاری دقیق این موقعیت را نمی توان از مجموعه داده های فعلی حل کرد.
در سری CACHE2_1418_37، پنج آنالوگ که ناحیه پیریمیدین اتر و آمینوفنیل را اصلاح میکردند غیرفعال بودند. تعداد محدود آنالوگ و عدم وجود هر گونه فعالیت مانع از تفسیر SAR برای این سری می شود.
در سری CACHE2_1418_52، چهار آنالوگ از دوازده آنالوگ فعالیت اتصال را نشان دادند (کد = 48-189 μM) و سه پاسخ SPR خطی بدون اشباع را نشان دادند. دو مشاهدات در آنالوگ های فعال سازگار هستند. اول، دو آنالوگ قدرتمند: CACHE2-HO_1418_26 (کد = 48 μM، گروه آسیل 4-کلروتیازول، HBD = 2) و CACHE2-HO_1418_28 (کد = 56 μM، گروه آسیل دو حلقهای تیازولایندولیزینون، HBD = 2)، هر دو هتروسیکلهای حاوی گوگرد فشرده را بهعنوان گروههای آسیل مستقیم و بدون فاصلهدهنده متیلن، تنها با کاهش 1.5 تا 1.75 برابری قدرت نسبت به مادر، دارند. این نشان میدهد که فاصلهدهنده متیلن موجود در عنصر اصلی مورد نیاز نیست و هتروسیکلهای گوگرد معطر فشرده در این موقعیت تحمل میشوند. دوم، آنالوگ های حاوی آمین های اولیه آزاد در گروه آسیل: CACHE2-HO_1418_23 (گروه آسیل 4-آمینوفنیل اوره، HBD = 4، کد = 167 μM) و CACHE2-HO_1418_24 (گروه آسیل 2-آمینو-5-بروموپیریدین، HBD = 3، کد = 189 μM)، با وجود حفظ هسته داربست، 5 تا 6 برابر فعالیت کمتری نسبت به والد نشان می دهد. هر دو تعداد HBD بالاتری نسبت به همتایان فعال دارند، مطابق با یک محیط اتصال که ممکن است به آسانی اهداکنندگان پیوند هیدروژنی اضافی را در خود جای دهد، اگرچه مجموعه دادهها برای ایجاد یک روند قوی بسیار کوچک است. CACHE2-HO_1418_27، که هم ستون فقرات هسته و هم هندسه پیوند دهنده را تغییر میدهد، و CACHE2-HO_1418_30، که اتصال هسته را تغییر میدهد، غیرفعال هستند، مطابق با هسته ضروری برای فعالیت.
در سری CACHE2_1418_68، یکی از پنج آنالوگ فعالیت اتصال را نشان داد. CACHE2-HO_1418_34 (کد = 78 μM، HBD = 1) گروه آسیل اصلی 2-آمینو-4-کلرو-5-هیدروکسی فنیل را با یک گروه ایندازولیل جایگزین میکند و یک گروه آسیل معطر مستقیماً متصل را حفظ میکند و در عین حال همه جایگزینهای قطبی را حذف میکند، با کاهش کارایی 3 برابری. در مقابل، HO_1418_32، که گروه NH2 را حفظ می کند اما سیستم حلقه را اصلاح می کند، و CACHE2-HO_1418_33 و CACHE2-HO_1418_35، که یک پیوند دهنده متیلن را به گروه های آسیلی غیر معطر معرفی می کنند، همگی غیرفعال هستند. CACHE2-HO_1418_36، با یک گروه آسیل فلوروبنزوکرومانول مستقیماً متصل، نیز غیر فعال است. این مشاهدات با الزامات اتصال مستقیم گروههای اسیل معطر در این سری مطابقت دارد، اگرچه تعداد کمی از آنالوگها مانع از نتیجهگیری قطعی در مورد سهم جایگزینهای فردی میشود. عدم بهبود قدرت نسبت به ترکیبات اصلی در هر یک از چهار سری، نشاندهنده اثر ترکیبی سنتز آنالوگ ناقص به دلیل محدودیتهای در دسترس بودن بلوکهای ساختمانی، تعداد محدود آنالوگهای آزمایششده، و عدم قطعیت ذاتی اندازهگیریهای SPR در این سطوح تمایل است – عواملی که با یک کمپین بهینهسازی کامل SAR در مراحل اولیه سازگار است. یافته های SAR در هر چهار سری در جدول تکمیلی 6 خلاصه شده است.
اعمال گردش کار V-SYNTHES2 در CBLB
برای آزمایش بیشتر کاربرد روش، ما از الگوریتم V-SYNTHES2 برای غربالگری بازدارندههای دامنه اتصال تیروزین کیناز (TKB) لیگاز یوبیکوئیتین-پروتئین لیگاز CBL-B (CBLB) در CACHE Challenge #4 استفاده کردیم. CBLB یک لیگاز E3 یوبیکوئیتین است و یک هدف مهم در ایمونوتراپی سرطان است زیرا نقش کلیدی در تنظیم منفی فعال شدن سلول T دارد.45،46. CBLB از چندین حوزه تشکیل شده است، یک ناحیه مارپیچ پیوندی کوتاه (LHR)، یک دامنه پیوندی تیروزین کیناز شناسایی بستر (TKBD)، و یک دامنه حلقه حلقه که به مجتمع های E2-ubiquitin متصل می شود. در ترکیب غیرفعال (بسته)، باقیماندههای دامنه TKBD و LHR با یکدیگر تعامل دارند و در نتیجه یک دامنه حلقه حلقهای ایجاد میشود که در مقابل محل اتصال بستر قرار میگیرد. پس از فسفوریلاسیون، پروتئین به یک ترکیب فعال (باز) تبدیل میشود و تغییرات ساختاری قابل توجهی را تجربه میکند که امکان تعامل مؤثرتر بین دامنه انگشت حلقه و پروتئین E2 را فراهم میکند.47. بنابراین، حفظ ترکیب بسته CBLB با مهار مولکول کوچک مهم است.
ساختار کریستالی CBLB در کمپلکس با بازدارنده C7683 (PDB ID: 8GCY47با وضوح 1.81 Å) برای غربالگری مجازی توسط چالش CACHE پیشنهاد شد. برای اعتبارسنجی مدل اتصال بر اساس ساختار کریستالی با شماره دسترسی 8GCY، مجموعه داده ای شامل 29 ترکیب فعال و 1450 مولکول طعمه را جمع آوری کردیم. دارایی ها توسط سازمان دهندگان CACHE Challenge شماره 4 ارائه شد، در حالی که فریب ها با استفاده از وب سرور DUD-E تولید شدند.
اتصال با استفاده از این مجموعه از معیارها انجام شد و عملکرد مدل با ایجاد یک منحنی ROC و محاسبه مساحت زیر منحنی (AUC) ارزیابی شد. مدل به AUC 96% دست یافت. نتایج بسیار خوب اتصال را باید با این احتیاط مشاهده کرد که ترکیبات فعال دارای داربست مشابهی هستند که تنوع شیمیایی را کاهش می دهد. علاوه بر این، یک مطالعه اتصال مجدد برای مدل انتخابی انجام شد که تکرارپذیری با لیگاند متصل متبلور شده را نشان میدهد (شکل 6).
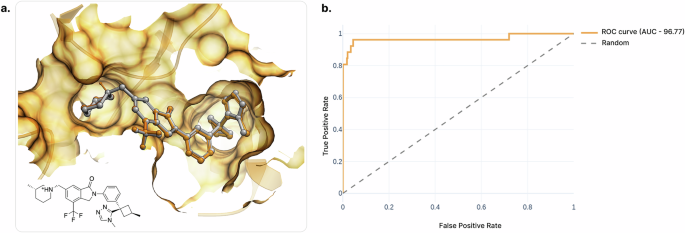
الف مقایسه وضعیت اتصال کریستالوگرافی تجربی مهارکننده C7683 با حالت محاسباتی در حوزه اتصال تیروزین کیناز (TKB) CBLB (PDB ID: 8GCY، وضوح 1.81 اینچ). حالت اتصال از ساختار کریستالی به صورت چوب خاکستری نشان داده شده است. حالت به دست آمده پس از اتصال مولکولی در مدل داکینگ آماده شده به صورت چوب نارنجی نشان داده شده است. ب منحنی مشخصه عملکرد گیرنده (ROC) با اتصال 29 ترکیب فعال و 1450 مولکول فریبنده DUD-E در مدل اتصال CBLB معتبر ایجاد شده است. منحنی جامد نشان دهنده عملکرد مدل است. خط چین مورب نشان دهنده کارایی تصادفی (AUC = 50%) است. این مدل به سطح زیر منحنی (AUC) 96 درصد دست یافت که نشان دهنده غنیسازی قوی ترکیبات فعال است، با این نکته که ترکیبات فعال دارای داربست مشابهی هستند. CBLB Casitas B-Cell Lymphoma-b، TKB Tyrosine Kinase-Binding Domain، PDB Protein Bank Data، گیرنده ROC مشخصه عملیاتی، AUC ناحیه زیر منحنی، DUD-E فهرست دکوهای مفید بهبود یافته است.
انتخاب و سنتز بازدیدهای نامزد برای CBLB
ما غربالگری V-SYNTHES2 را با استفاده از پروتکلی شبیه به پروتکل بالا انجام دادیم، تنها با تغییرات جزئی در روش CBLB. ما 1.88 میلیون قطعه از واکنشهای 2 جزیی و 120000 قطعه از واکنشهای 3 جزء را به مدل پروتئین آمادهشده متصل کردیم. قطعات MEL با امتیاز بالا در 1.5 میلیون مولکول کامل از هر زیرفضا فهرست شدند و ترکیبات کامل به دست آمده متصل شدند. ما 30000 ترکیب 2 جزئی با امتیاز بالا و 60000 ترکیب 3 جزئی را برای پردازش بیشتر به دست آوردیم.
فرآیند انتخاب یک نامزد همجوشی شامل چندین مرحله است. استفاده ترکیبی از امتیاز اتصال، RTCNN، فیزیکوشیمیایی، و فیلترهای سمیت/واکنشپذیری، 90000 ترکیب اولیه با امتیاز بالا را قبل از خوشهبندی و بازرسی بصری متخصص کاهش داد (جدول تکمیلی 2). ابتدا، ترکیبات با استفاده از امتیاز اتصال (برش -40.0) و امتیاز RTCNN (برش -20.0) فیلتر شدند. سپس فیلترهای عمومی مانند PAINS، Rapid Elimination of Swill (REOS)، قانون پنج لیپینسکی و BadGroups (ICM-Pro) را برای حذف ترکیباتی با خواص فیزیکی و شیمیایی نامناسب، گروه های عملکردی ناخواسته و موارد مثبت کاذب اعمال کردیم.
سپس ترکیبات با امتیاز بالا بر اساس برهمکنش با باقی مانده های کلیدی Y363 که برای تنظیم فعالیت CBLB حیاتی است و F263 که در دامنه TKB قرار دارد به سه گروه تقسیم شدند. گروه اول شامل مولکول هایی است که با F263 و Y363 پیوند هیدروژنی تشکیل می دهند که ممکن است به پایداری دامنه TKB و LHR کمک کند. گروه دوم شامل لیگاندهایی است که فقط با Y363 پیوند هیدروژنی تشکیل می دهند (جدول تکمیلی 7). گروه سوم شامل ترکیباتی است که با باقیمانده های کلیدی پیوند هیدروژنی تشکیل نمی دهند، اما نتایج اتصال خوبی را نشان می دهند و ناحیه عمیق تری از محل اتصال را اشغال می کنند. برای اطمینان از تنوع لیگاند، ما یک رویکرد مبتنی بر synthon را برای گروه بندی ترکیبات اعمال کردیم. سپس موقعیت اتصال 1000 مولکول باقی مانده توسط کارشناسان بررسی شد.
در نتیجه، 89 ترکیب برای سنتز در اولویت قرار گرفتند، که 69 مورد توسط Enamine سنتز شدند (77.5٪ میزان موفقیت مصنوعی) و در شرایط آزمایشگاهی در برابر CBLB آزمایش شدند (جدول تکمیلی 7). در مجموع، 6 روش مختلف مصنوعی برای جمع آوری مولکول های انتخابی (روش ها) استفاده شد. ترکیبات انتخاب شده توسط Enamine با خلوص بیش از 95 درصد سنتز شدند. اطلاعات توصیفی تحلیلی برای همه ترکیبات سنتز شده در اطلاعات تکمیلی ارائه شده است.
خصوصیات لیگاندهای جدید CBLB
سنجش پلاریزاسیون فلورسانس (FP) برای غربالگری اولیه 69 ترکیب انتخابی در غلظت 50 میکرومولار استفاده شد (شکل 7a). سه ترکیب، لیگاند CBLB را جابجا کردند، و پاسخ سنجش را به کمتر از 85 درصد کنترل کاهش دادند، و این بازدیدهای اولیه به یک سنجش دوز-پاسخ ارتقا یافتند. ترکیب منفرد CACHE4HI_1955_60 (Z8710104284) منحنی دوز-پاسخ را نشان داد. کد از 111.9μM که معیارهای انتخاب ضربه را رد کرد (کد7c,d). پس از اندازهگیری تجمع و حلالیت توسط DLS، CACHE4HI_1955_60 معیارهای از پیش تعریفشده ضربه را برآورده کرد و به سمت گسترش پیش رفت. 23 شرکت کننده مختلف در CACHE، به عنوان ترکیبات ضربه شناسایی شدند و به مرحله گسترش ضربه، که هر یک از یک استخر جداگانه منشا میگرفتند، ادامه دادند.
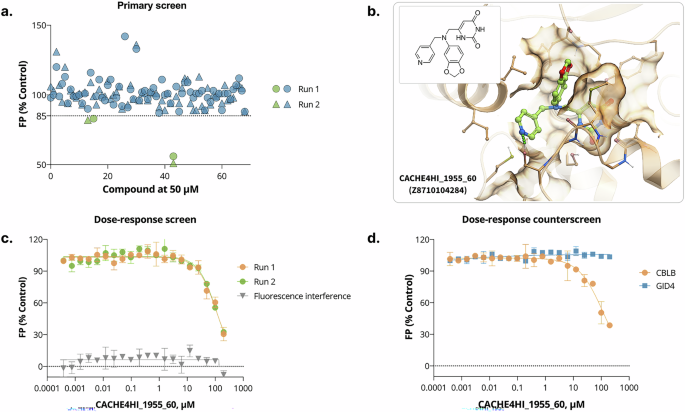
الف نتایج غربالگری پلاریزاسیون فلورسانس اولیه (FP) برای 69 ترکیب سنتز شده در برابر CBLB در 50 میکرومولار آزمایش شده است. خط چین افقی آستانه پاسخ 85% را نشان می دهد. دایره های پر شده زیر این آستانه، ترکیبات پیشرفته ای را برای آزمایش های دوز-پاسخ نشان می دهند. ب ساختار شیمیایی کاندید ضربه CACHE4HI_1955_60 و وضعیت اتصال پیشبینیشده آن در حوزه TKB CBLB. اتم نیتروژن در موقعیت پارا حلقه فنیل یک پیوند هیدروژنی با باقیمانده S368 تشکیل می دهد که با یک خط چین سبز نشان داده می شود. ج منحنی دوز-پاسخ FP CACHE4HI_1955_60 در مقابل CBLB که ثابت تفکیک (کد ) از 111.9 میکرومولار (ص = 2، تکرارهای فنی). ترکیب با معیار انتخاب ضربه از پیش تعریف شده مطابقت دارد کد d منحنی دوز-پاسخ متضاد FP CACHE4HI_1955_60 در برابر پروتئین GID4 نامرتبط که تغییر سوبسترای قابل توجهی را در محدوده غلظت آزمایش شده نشان نمی دهد (ص = 2، تکرارهای فنی)، انتخاب الزام آور را تایید می کند. پلاریزاسیون فلورسانس FP، کدثابت تفکیک تعادل، لنفوم سلول B CBLB Casitas-b، دامنه اتصال به تیروزین کیناز TKB، زیرواحد کمپلکس GID4 GID 4، n تعداد تکرار، موقعیت 4 حلقه فنیل، CACHE ارزیابی انتقادی آزمایشهای ضربهیابی محاسباتی.
گسترش محدود تعداد بازدیدهای اصلی V-SYNTHES2
ضربه شناسایی شده CACHE4HI_1955_60 از یک واکنش 2 جزیی به دست آمد. مولکول های بعدی با تغییر سنتون های موجود در مولکول ضربه ایجاد شدند. علاوه بر این، ما از روش هایی مانند FTrees، SpaceMACS و SpaceLight برای جستجوی ترکیبات مشابه در فضای واقعی استفاده کردیم. با این حال، داربست ترکیب ضربه در Enamine xREAL Space ضعیف نشان داده شد و در نتیجه تعداد محدودی آنالوگ به وجود آمد. پس از اتصال مولکولی، 26 آنالوگ برای سنتز در اولویت قرار گرفتند که 13 (50٪) با موفقیت سنتز شدند (جدول تکمیلی 8). مانند سری NSP13، در دسترس بودن محدود یکی از بلوکهای ساختمانی مانع از تکمیل تمام آنالوگهای پیشبینیشده شد و برنامه فشرده پروژه اجازه سنتز مجدد را نمیداد. پروتکل های مصنوعی در روش ها و داده های QC در اطلاعات تکمیلی ارائه شده است. همه ترکیبات فاقد آنالوگ نزدیک (شباهت Tanimoto > 0.6) در ChEMBL تایید شد (جدول تکمیلی 8).
ترکیبات سنتز شده، بستر را در سنجش FP جابجا نکردند (شکل 8c). تجزیه و تحلیل دقیق این نتایج نشان داد که همه آنالوگ های آزمایش شده با ضربه اصلی در موقعیت اتم نیتروژن متفاوت هستند (به اطلاعات تکمیلی مراجعه کنید). در ضربه اولیه (CACHE4HI_1955_60)، اتم نیتروژن در موقعیت پارا حلقه فنیل قرار داشت که با توجه به نتایج اتصال، امکان تشکیل پیوند هیدروژنی با S368 را فراهم کرد (شکل 8a). اهمیت این پیوند هیدروژنی با آزمایش نزدیکترین آنالوگ، CACHE4HO_1955_5 (Z9151908629) تایید شد که در آن اتم نیتروژن در موقعیت متا قرار دارد. این تغییر موقعیت منجر به از دست دادن پیوند هیدروژنی و بنابراین کاهش فعالیت در سنجش FP شد (شکل 8b)، که یک نتیجه مهم برای بهینه سازی بیشتر این ضربه است.
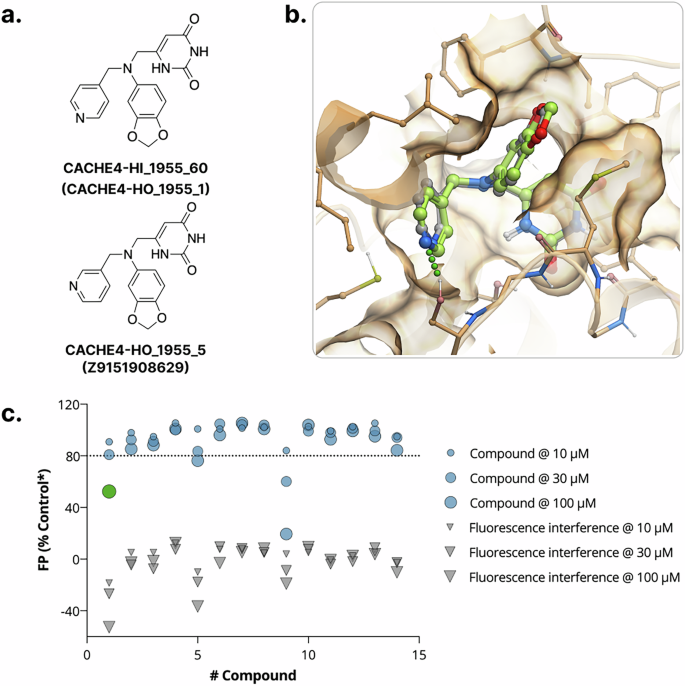
الف ساختارهای شیمیایی دور 1 نامزد CACHE4HI_1955_60 (سمت چپ) و نزدیکترین همتای دور 2 آن CACHE4HO_1955_5، تفاوت ساختاری کلیدی را برجسته می کند: اتم نیتروژن موقعیت پاراحلقه فنیل را در موقعیت CACHE4HI_1955 meHO_61 و CACHE4HI_1955 meHO_61 و CACHE4HI_1955 meHO_60 را اشغال می کند. ب موقعیتهای اتصال پیشبینیشده CACHE4HI_1955_60 (بهعنوان چوبهای سبز نشان داده شده) و CACHE4HO_1955_5 (نشان داده شده بهعنوان چوبهای خاکستری) در دامنه TKB CBLB. پارا نیتروژن CACHE4HI_1955_60 یک پیوند هیدروژنی با باقیمانده S368 تشکیل می دهد که با یک خط چین سبز نشان داده شده است. متا نیتروژن CACHE4HO_1955_5 دور از S368 قرار گرفته است، این تعامل را حذف می کند و نقش حیاتی موقعیت نیتروژن را برای درگیری هدف تایید می کند. ج نتایج غربالگری پلاریزاسیون فلورسانس (FP) برای تمام 13 آنالوگ دور 2 آزمایش شده در سه نقطه غلظت نشان داده شده به عنوان دایره های پر شده است. هیچ یک از آنالوگ های دور 2، بستر CBLB را بالاتر از آستانه فعالیت جابجا نکرد، که مطابق با از دست دادن پیوند هیدروژنی کلیدی با S368 مشاهده شده در سنجش docking بود. پلاریزاسیون فلورسانس FP، لنفوم سلول B CBLB Casitas-b، دامنه اتصال به تیروزین کیناز TKB، رابطه ساختار-فعالیت SAR، پارا موقعیت 4 حلقه فنیل، موقعیت متا 3 حلقه فنیل، ارزیابی انتقادی CACHE آزمایشهای محاسباتی برای یافتن ضربهها.